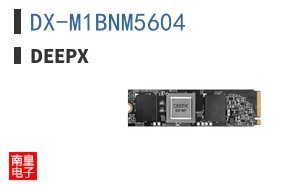
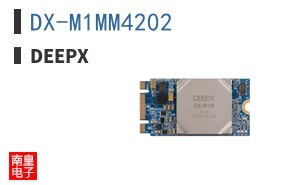
DEEPX公司推出的DX-M1边缘AI处理器,是面向边缘计算场景设计的高能效AI加速芯片。该系列产品基于自研的神经网络处理单元架构,在功耗受限的嵌入式环境中实现高效的深度学习推理。与依赖云端算力的传统方案不同,DX-M1将推理能力下沉至设备端,有效降低数据传输延迟与带宽开销,同时满足工业与消费场景对数据隐私和实时响应的严苛要求。
从技术原理看,DX-M1采用异构计算架构,将NPU、CPU与专用内存子系统紧密耦合,针对卷积神经网络、Transformer等主流模型进行指令级优化。其核心优势在于算力与能效的平衡:通过量化压缩、算子融合与动态电压频率调节,芯片在典型视觉推理任务中可维持较低的功耗预算,同时保持较高的帧率吞吐。对于需要在多路摄像头输入下并行处理的目标检测、分类与分割任务,DX-M1提供了可扩展的算力配置。
选型时需重点关注几个维度。首先是模型兼容性,DX-M1配套的编译器工具链支持ONNX、TensorFlow等框架的模型转换,并针对量化感知训练提供校准流程,降低部署门槛。其次是接口与内存带宽,芯片提供MIPI、PCIe等高速接口,便于与图像传感器或主控平台协同。此外,开发者应评估热设计功耗与封装形式是否匹配目标产品的散热条件。对于需要快速导入量产的团队,可借助DEEPX总代理获取完整的评估套件与技术支持。
典型应用场景覆盖智能安防、工业机器视觉、智慧零售与车载感知。在安防领域,DX-M1可支持多路视频流的人形与车辆检测,在边缘侧完成结构化数据提取,减轻后端服务器压力。在工业质检中,其低延迟特性适合高速产线上的缺陷识别。在零售场景,该处理器可用于客流分析、货架状态监测等任务。相比通用GPU方案,DX-M1在单位功耗算力上更具优势;相比纯ASIC方案,其可编程性又为算法迭代保留了空间。
与同类边缘AI芯片相比,DX-M1的差异化在于软硬协同的设计思路。DEEPX不仅提供芯片,还构建了从模型优化、编译部署到运行时调度的完整软件栈,减少了客户在底层适配上的投入。同时,该系列产品在多模型并行与动态负载切换方面进行了针对性优化,适应边缘设备任务多样化的趋势。对于系统集成商而言,这意味着更短的开发周期与更可控的总体拥有成本。
总体来看,DX-M1边缘AI处理器代表了边缘智能从“能跑模型”向“高效跑好模型”演进的方向。其价值不仅体现在峰值算力指标上,更在于对实际部署约束的深入理解功耗、延迟、成本与开发效率的综合平衡。随着边缘侧AI应用从试点走向规模化,这类兼顾灵活性与能效的处理器将成为智能终端升级的关键组件。